OGO_SEP.jpg" width="110" />


  • .
    .

    DATO

    Datos: Es una característica  u información referente a un solo individuo u objeto.Es una representación simbólica (numérica, alfabética, algorítmica etc.), un atributo o una característica de una entidad. Los datos son hechos que describen sucesos y entidades. No tienen ninguna información. Puede significar un numero, una letra, o cualquier símbolo que representa una palabra, una cantidad, una medida o una descripción.
    El dato no tiene valor semántico (sentido) en sí mismo, pero si recibe un tratamiento (procesamiento) apropiado, se puede utilizar en la realización de cálculos o toma de decisiones. Es de empleo muy común en el ámbito informático y, en general, prácticamente en cualquier disciplina científica.
     

    MI CALAMEO


    TIPOS DE RELACIONES EN LAS BASES DE DATOS


    Relaciones "uno a uno"

    Estas relaciones entre bases de datos se dan cuando cada campo clave aparece sólo una vez en cada una de las tablas.
    Tomando un ejemplo del mundo real, una clara relación de "uno a uno" podría ser, el nombre de cualquier persona y su número de teléfono. Si partimos del supuesto en que cada persona tiene un solo número de teléfono, se podría hablar de una relación "uno a uno".
    Garrafalmente, se podría representar de la siguiente manera:
    Este tipo de relaciones se caracteriza poque cada uno de los campos define a aquél con el que se relaciona. Es decir, conociendo el nombre de una persona podemos conocer su número telefónico. O si sabemos su número telefónico, podemos identificar al dueño. En estos cases, se suele aconsejar incluir todos los datos dentro de una sola tabla.

    Relaciones de "uno a varios"

    El ejemplo del caso anterior (cada persona, un teléfono), si bien es correcto teóricamente, es muy improbable desde el punto de vista de la realidad. Con la gran expansión de los teléfonos, por lo general, cada persona tiene un número de teléfono fijo, y además del teléfono móvil. Debemos tener en cuenta que de el de su casa también tendrá un número de teléfono de empresa, y que quizá también sus móviles estén divididos en ocio y trabajo.
    Por ello, debemos tener nuestras bases de datos preparadas para ello. Este tipo de relaciones es conocido como "uno a varios", y se podría representar de la siguiente manera:

    En este caso, lo aconsejable no es almacenar todos los datos en una sola tabla, sino lo eficiente es hacerlo en tablas separadas, utilizando el identificador ID para relacionarlas.

    Relaciones de "varios con varios"
    La última de la relaciones que podemos encontrar es la de "varios con varios". Dado que en la vida las cosas rara vez son sencillas, éste será el tipo de relación que nos encontraremos más a menudo.
    Volviendo al tema de los teléfonos, hemos encontrado la manera de relacionar cada una de las personas con sus diversos teléfonos: el de su casa, el de su empresa, el móvil. Pero no será extraño tener en nuestra base de datos diversas personas que trabajen en la misma empresa, por lo que el número de su trabajo será el mismo, o miembros de una misma familia, por lo que compartirán el mismo teléfono de su hogar.
    ¿Cómo tratar este tipo de relaciones? Si nos limitamos a repetir dicho número de tablas, estaremos creando problemas de redundancia de datos, que a largo plazo lastrarán la rapidez y eficacia de nuestras tablas.
    Este tipo de relaciones podría ilustrarse de la siguiente manera:

    Como vemos, cada elemento de la base de datos puede relacionarse libremente con uno o varios miembros de las distintas tablas.
    En estos casos no hay una regla fija a la que podamos acogernos, pero lo aconsejable es aproximarse lo más posible a la realidad, y no dudar en establecer tablas intermedias que nos ayuden a asociar mejor los datos.
    Volviendo al tema de los teléfonos, imaginemos que varias personas de nuestra tabla trabajan en la misma empresa ACME Productions tiene varias líneas, por lo que los números de teléfono de trabajo de estas personas serían varios. ¿Cómo representarlo en nuestra base de datos?
    Relaciones de "varios  a uno"
     
    Una entidad en A se relaciona exclusivamente con una entidad en B. Pero una entidad en B se puede relacionar con 0 o muchas entidades en A.

    BASE DE DATOS

    ¿Qué es una base de datos?
    Una base de datos (cuya abreviatura es BD) es una entidad en la cual se pueden almacenar datos de manera estructurada, con la menor redundancia posible. Diferentes programas y diferentes usuarios deben poder utilizar estos datos. Por lo tanto, el concepto de base de datos generalmente está relacionado con el de red ya que se debe poder compartir esta información. De allí el término base. “Sistema de información” es el término general utilizado para la estructura global que incluye todos los mecanismos para compartir datos que se han instalado.
     bdd-images-basecs

    ¿Por qué utilizar una base de datos?


    Una base de datos proporciona a los usuarios el acceso a datos, que pueden visualizar, ingresar o actualizar, en concordancia con los derechos de acceso que se les hayan otorgado. Se convierte más útil a medida que la cantidad de datos almacenados crece.
    Una base de datos puede ser local, es decir que puede utilizarla sólo un usuario en un equipo, o puede ser distribuida, es decir que la información se almacena en equipos remotos y se puede acceder a ella a través de una red.
    La principal ventaja de utilizar bases de datos es que múltiples usuarios pueden acceder a ellas al mismo tiempo.

    Administración de bases de datos

    Rápidamente surgió la necesidad de contar con un sistema de administración para controlar tanto los datos como los usuarios. La administración de bases de datos se realiza con un sistema llamado DBMS (Database management system [Sistema de administración de bases de datos]). El DBMS es un conjunto de servicios (aplicaciones de software) para administrar bases de datos, que permite:
    • un fácil acceso a los datos
    • el acceso a la información por parte de múltiples usuarios
    • la manipulación de los datos encontrados en la base de datos (insertar, eliminar, editar)

    bdd-images-sgbd

    El DBMS puede dividirse en tres subsistemas:
    • El sistema de administración de archivos:
      para almacenar información en un medio físico
    • El DBMS interno:
      para ubicar la información en orden
    • El DBMS externo:
      representa la interfaz del usuario

    APLICACIÓN DE ESTRUCTURAS DE CONTROL

    Programa que muestra un menú de opciones y realiza el calculo correspondiente a la elegida, si el usuario lo decea puede repetir otro o el mismo calculo.


    Esta es la imagen del programa en ejecución que
    muestra el menú y el inicio de mi programa.
    
    Esta es una imagen de un pequeño texto del
    código del programa en Pascal.

    9.-HISTORIA DE LA PROGRAMACION

    HISTORIA DE LA PROGRAMACION


    Sobre los últimos 50 años, los idiomas que programan han evolucionado del código binario de máquina a herramientas poderosas que crean las abstracciones complejas. Es importante entender por qué los idiomas han evolucionado, y qué capacidades que los idiomas más nuevos nos dan.

    "Tan largo como no había máquinas, programar era ningún problema; cuando tuvimos unos pocas computadoras débiles, programar llegó a ser un problema templado y ahora que tenemos las computadoras gigantescas, programar ha llegado a ser un problema igualmente gigantesco. En este sentido que la industria electrónica no ha resuelto un solo problema, tiene sólo los creó - ha creado el problema de usar su producto". [Edsger. W. Dijkstra. "El Programista Humilde" (la Conferencia del Premio de Turing), Comunicaciones del ACM, Vol 15, No. 10 (el octubre 1972).]

    E. W. Dijkstra habló estas palabras proféticas casi hace 28 años en su es la conferencia del Premio de Turing. En aquel momento, el 'las computadoras gigantescas él radio de probablemente tenido entre 64 y 128 kilobytes de la memoria verdadera, y a lo más unos pocos mega octetos de artefactos de almacenamiento de acceso directo. Si él pensó que el problema era gigantesco entonces...

    Uno de las llaves a programar exitoso son el concepto de la abstracción. La abstracción es la llave a la construcción sistemas complejos de software. Como el tamaño de nuestros problemas crece, la necesidad para la abstracción dramáticamente aumentos. En sistemas sencillos, característica de idiomas usados en el 1950s y '60s, un solo programista podría entender el problema entero, y por lo tanto manipula todas estructuras del programa y datos. Los programistas son hoy incapaces de entender todos los programas y los datos - es apenas demasiado grande. La abstracción se requiere a permitir que el programista para agarrar los conceptos necesarios.

    La mayoría de los libros y el reglamento en la historia de programar los idiomas tienden a discutir los idiomas en términos de generaciones. Esto es un arreglo útil para clasificar los idiomas por la edad.

    Primera Generación
    Al desarrollarse las primeras computadoras electrónicas, se vio la necesidad de programarlas, es decir, de almacenar en memoria la información sobre la tarea que iban a ejecutar. Las primeras se usaban como calculadoras simples; se les indicaban los pasos de cálculo, uno por uno.

    John Von Neumann desarrolló el modelo que lleva su nombre, para describir este concepto de "programa almacenado". En este modelo, se tiene una abstracción de la memoria como un conjunto de celdas, que almacenan simplemente números. Estos números pueden representar dos cosas: los datos, sobre los que va a trabajar el programa; o bien, el programa en sí.

    ¿Cómo es que describimos un programa como números? Se tenía el problema de representar las acciones que iba a realizar la computadora, y que la memoria, al estar compuesta por switches correspondientes al concepto de bit, solamente nos permitía almacenar números binarios.

    Los lenguajes más primitivos fueron los lenguajes de máquina. Esto, ya que el hardware se desarrolló antes del software, y además cualquier software finalmente tiene que expresarse en el lenguaje que maneja el hardware.

    La programación en esos momentos era sumamente tediosa, pues el programador tenía que "bajarse" al nivel de la máquina y decirle, paso a pasito, cada punto de la tarea que tenía que realizar. Además, debía expresarlo en forma numérica; y por supuesto, este proceso era propenso a errores, con lo que la productividad del programador era muy limitada. Sin embargo, hay que recordar que en estos momentos, simplemente aún no existía alternativa.

    Segunada Generación
    El primer gran avance que se dio, como ya se comentó, fue la abstracción dada por el Lenguaje Ensamblador, y con él, el nacimiento de las primeras herramientas automáticas para generar el código máquina. Esto redujo los errores triviales, como podía ser el número que correspondía a una operación, que son sumamente engorrosos y difíciles de detectar, pero fáciles de cometer. Sin embargo, aún aquí es fácil para el programador perderse y cometer errores de lógica, pues debe bajar al nivel de la forma en que trabaja el CPU, y entender bien todo lo que sucede dentro de él.

    Tercera Generación
    Con el desarrollo en los 50s y 60s de algoritmos de más elevado nivel, y el aumento de poder del hardware, empezaron a entrar al uso de computadoras científicos de otras ramas; ellos conocían mucho de Física, Química y otras ramas similares, pero no de Computación, y por supuesto, les era sumamente complicado trabajar con lenguaje Ensamblador en vez de fórmulas. Así, nació el concepto de Lenguaje de Alto Nivel, con el primer compilador de FORTRAN (FORmula TRANslation), que, como su nombre indica, inició como un "simple" esfuerzo de traducir un lenguaje de fórmulas, al lenguaje ensamblador y por consiguiente al lenguaje de máquina. A partir de FORTRAN, se han desarrollado innumerables lenguajes, que siguen el mismo concepto: buscar la mayor abstracción posible, y facilitar la vida al programador, aumentando la productividad, encargándose los compiladores o intérpretes de traducir el lenguaje de alto nivel, al lenguaje de computadora.

    Cuarta Generación
    Los idiomas de la cuarta generación parecen según las instrucciones a las de la tercera generación. Lo nuevo de estas lenguajes son conceptos como clases, objetos y eventos que permiten soluciones más fáciles y lógicos. Lenguajes como C++, java y C# se llaman lenguajes orientadas al objeto.

    Los idiomas modernos, tal como C++ y Java, no sólo permite las abstracciones, pero permite la implementación impuesta de restricciones en abstracciones. La mayoría de los idiomas modernos son objetivas orientado, que permite que mí modele el mundo verdadero que usa mi idioma. Además, puedo limitar el acceso para modelar las restricciones de mundo verdadero en datos. La llave es que usé el término "mundo verdadero." Por la primera vez, yo modelo mi solución en términos del problema. Quiero que mi solución sea orientado de problema, para que la solución refleje el mundo verdadero en términos de estructuras de datos y acceso a los datos. Yo también puedo aplicar directamente y para poder modelar objetos de mundo verdadero usando las clases (en C + + o Java).


    Quinta Generación
    Como la quinta generación están conocidos los Lenguajes de inteligencia artificial. Han sido muy valorados al principio de las noventa - mientras ahora el desarrollo de software toma otras caminos.

    Lo que veremos en el futuro es menos dependencia en el idioma, y más en el modelando herramientas, tal como el Unificado Modelando el Idioma (UML). La salida del modelando herramienta producirá mucho de nuestro código para nosotros; en el muy menos, producirá arquitectónico y los modelos del diseño y la estructura de nuestro código. Esto producirá un diseño (y posiblemente código) eso puede ser validado por el cliente antes de completar la implementación y probar. Cuando los problemas diarios que resolvemos llegan a ser más grande, nosotros tenemos cada vez menos tiempo "volver a hacer" el código. Los días de decir, "acabamos de escribir una versión de Beta y el cliente entonces pueden decir nosotros lo que ellos quieren realmente," son pasados. Las organizaciones que fallan de obtener completa y corrige los requisitos de cliente antes de escribir el código saldrá del negocio. ¿Por qué? Porque toma demasiado largo, y cuesta también mucho, para escribir código dos o más vez. Las organizaciones que tienen un compromiso a la comprobación y la validación antes de producir código prosperarán - los otros fallarán.


    Pasos importantes de las lenguajes de programación


    Historia de las lenguajes de programación


    8. PSEUDOCODIGO

    PSEUDOCODIGO
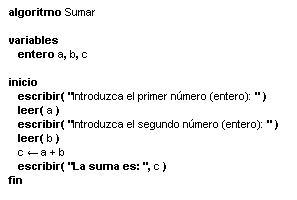
    Es un lenguaje que se asemeja a los lenguajes de programación en los que se crean software de programación para la PC pero sin el rigor y exactitud que estos tienen a nivel sintáctico; es una forma clara de escribir programas en un lenguaje común o cotidiano.

    Volver al inicio Volver arriba DYKHEM. Theme ligneous by pure-essence.net. Bloggerized by Chica Blogger.